
ARTICLE SIGNAL
AI下一幕:百万智能体与AI科学家如何重塑科研生产力
AI资讯,AI新闻,大模型,智能体协同,AI4S,人工智能,百度智能云,芯云模体,干湿实验闭环,科研自动化,LLM,算力底座,AI日报,AGI演进,智能组织
type
status
date
slug
summary
tags
category
icon
password
网址
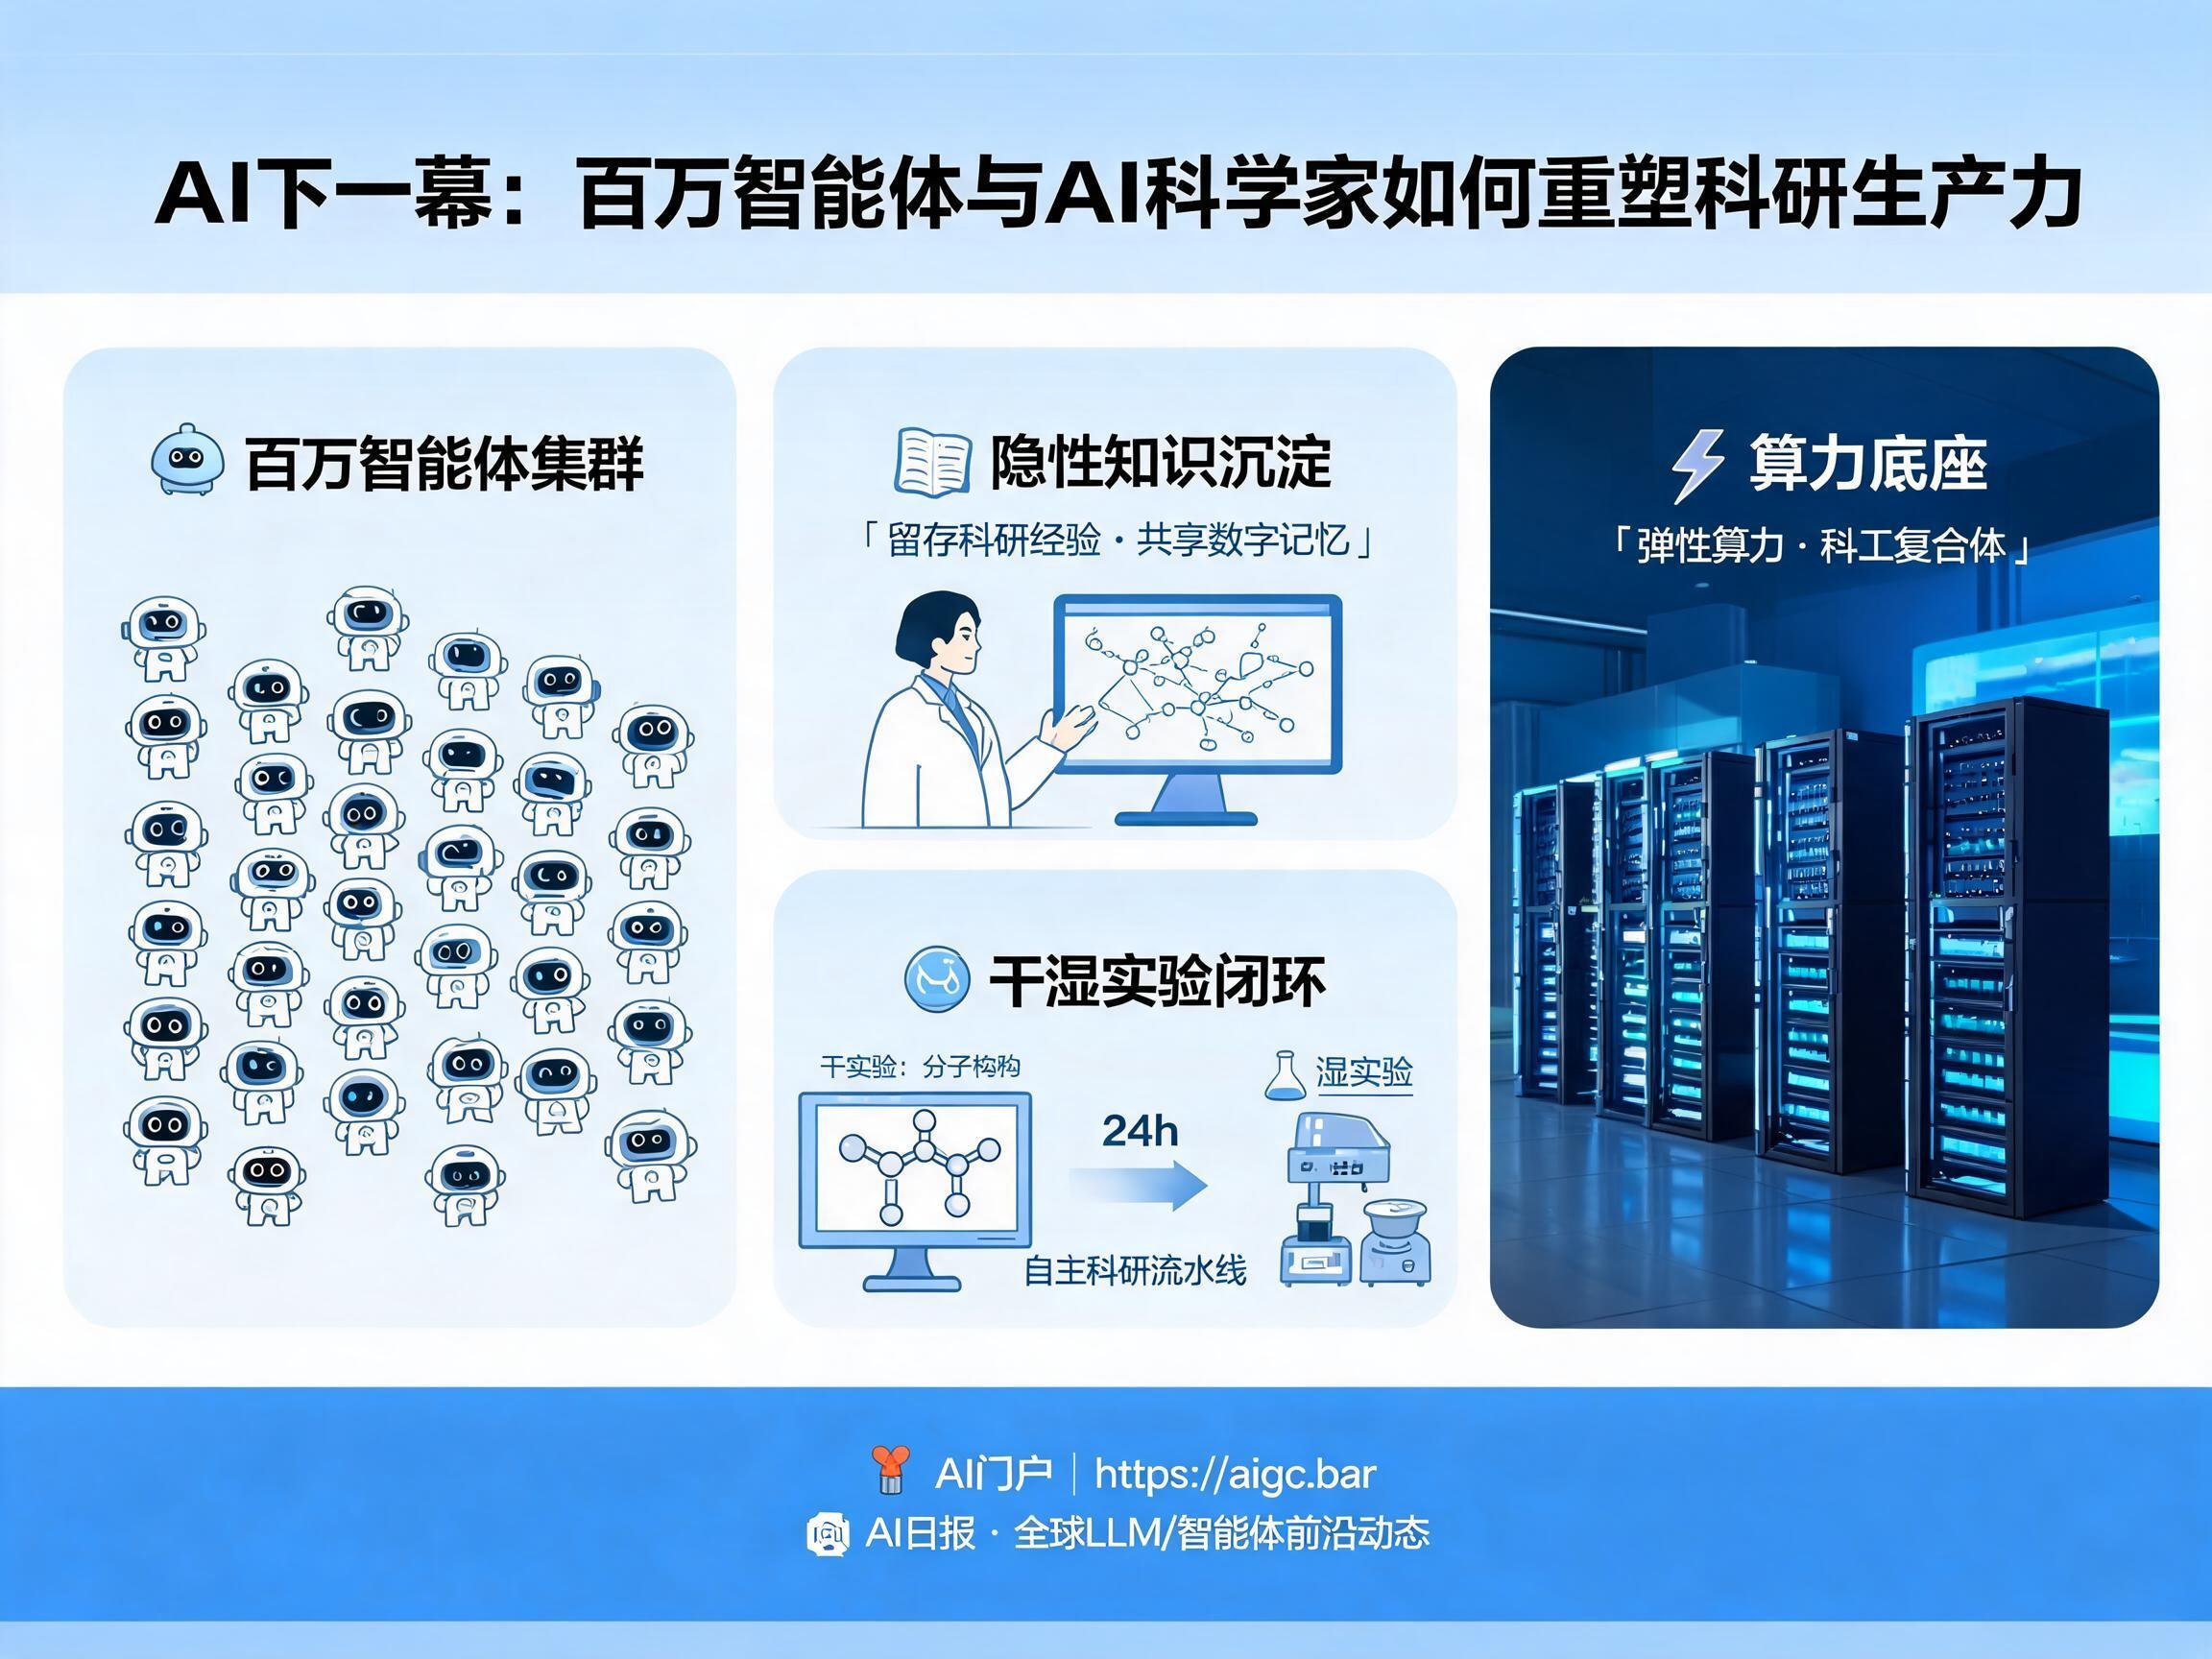
在过去一年中,全球人工智能技术的发展速度令人瞠目结舌。无论是千个智能体协同在几十小时内形式化复杂数学定理,还是大模型在无网络环境下独立推导复杂分子合成路径,抑或是多模态系统直接解析湿实验室的生化检测数据,种种迹象都在表明:AI(人工智能)已经从单纯辅助编码与文本写作的工具,全面迈向深度赋能前沿科研的“协同科学家”阶段。
然而,当全球科技巨头与科研机构纷纷引入顶尖的LLM(大语言模型)后,许多团队却发现实际产出并未如预期般爆发。算力孤岛、数据割裂、设备无法联动等问题,依然制约着生产力的释放。要让AGI的潜力真正转化为推动人类认知边界的现实生产力,行业必须从追求单个模型的参数规模,转向重构承载智能体的“智能组织”。关注前沿动态的读者可以在汇聚全球最新前沿动态的专业 AI门户 获取更多深度追踪与一手AI资讯。
从单兵作战到智能组织:为什么大模型需要“新厂房”
回顾工业革命历史,仅把蒸汽机或电动机搬进旧手工作坊,并不能立刻带来效率的飞跃,只有彻底重构流水线和厂房结构,现代工业才真正成型。当前人工智能的发展同样面临这一节点:如果只给科研人员配备单点AI助手,充其量只是提升了个体的手速,无法改变整体协作效率。
智能组织的核心理念正是打造AI时代的“新厂房”,其落地包含三个关键维度:
- 以任务为核心打破岗位边界:工业时代的单元是固定岗位,而在智能体集群协同的时代,任务流才是核心单元。人员与智能体围绕具体探索目标动态组合,一部分角色专注于拓展新边界(Builder),另一部分则负责校验结果与构建信任协同(Seller)。
- 沉淀非结构化隐性知识:科研人员脑海中的经验、 intuition(直觉)以及未成文的试错细节,是科研中最宝贵的资产。智能组织需要将这些碎片化知识显性化并沉淀入系统,转化为任何智能体均可调用的共享记忆。
- 构建自动化流程闭环:通过“结果可衡量 + 持续循环反馈(Looping)”的机制,让实验、分析、优化形成自动演进的正向飞轮。
从openai到claude等前沿大模型的进化路径可以看出,单点推理能力的提升正在触碰工程协同的天花板。只有通过体系化的软件与算力重塑组织流程,才能让智能体集群真正发挥出规模化效应。
沉淀隐性知识:用定制智能体留住科研人员的“调参手感”
在生命科学、高分子材料与尖端物理等实验学科中,科研团队普遍面临一个顽疾——“人走经验断”。经验丰富的资深研究员积累了海量无法写进公开论文的实验“手感”,一旦团队交接,新手往往要耗费数月甚至数年重新踩坑。
解决这一难题的关键在于通过软硬一体的智能架构将人脑智慧资产化:
- 会议与过程记录显性化:日常讨论中的学术灵感、试错共识与参数方向,由通用协作智能体全程提炼归档,形成结构化知识图谱。
- 实验数据全量入库:不仅保留成功的数据,更将大量失败的“废数据”及对应的背景条件完整留存,避免大模型在分析时陷入“盲人摸象”。
- 技能包资产化:将专家的调参准则、高通量生信脚本打包封装为特定的Skills(技能包),灌注给垂直领域的定制智能体。
通过这种方式,即便是刚进入实验室的新手,也能借助预置了专家经验的专业智能体,精准复现高难度实验,使前人的探索真正成为云端永不磨灭的基石。对于致力于探索AI变现与企业级落地方案的从业者而言,这种将专业隐性知识转化为数字资产的模式,同样是极具商业价值的演进路径。
打通干湿实验闭环:24小时不休眠的自主科研流水线
长期以来,科研流程中存在严重的“干湿分离”痛点。科研人员在电脑上通过算法设计出分子构型或优化序列(干实验),却不得不耗费大量时间守在实验台前手动配液、离心、检测(湿实验)。一旦实测数据与理论预期不符,整个流程就必须从头再来,迭代周期长达数周甚至数月。
如今,领先的科研架构正通过三大步将干湿实验打通为全自动闭环:
- 自然语言方案交互:研究人员利用精准的提示词(Prompt)向智能体输入目标属性与文献基准,快速迭代出多套实验预案。
- 可视化操作画布生成:系统自动将自然语言方案转化为仪器可识别的执行时序图,明确标注各台高通量移液工作站、检测仪器的参数与配比。
- 软硬件联动物理执行与实时反馈:自动化实验平台直接执行操作画布任务,并将跑出的第一手真实世界数据回传至大模型,即刻驱动下一轮假设推演与方案调整。
这种24小时不间断的自动化闭环,不仅把科研人员从枯燥机械的重复劳动中解脱出来,更彻底避免了纯靠合成数据训练模型带来的“近亲繁殖”与结果失真问题,为探索更深层次的科学规律提供了源源不断的高质量AI-ready数据。
算力底座与工程协同:破解成果转化的“双十定律”
新药研发与先进材料领域长期受制于“耗时10年、耗资10亿美金”的“双十定律”。近年来尽管文献产出剧增、算力大幅跃升,但临床与产业转化依然困难重重。究其根源,高校和研发机构往往专精于科学假设,却极度缺乏工业级的AI工程化交付能力。
为了跨越这一鸿沟,前沿科技产业正展现出全新的解题思路:
第一,构建“科工复合体”。派出资深前线工程专家直接进驻前沿实验室,由科学家负责提出底层科学构想,工程团队负责搭建全栈软件与系统,让算法在第一天就面向工业级产出设计。
第二,提供弹性高并发的智能基础设施。当AI算法在庞大的化学或物理空间中寻优时,往往会在瞬间衍生出数以千计的并行试错分支。这要求底层的计算平台必须具备在毫秒内弹性拉起海量隔离沙箱的能力,支持每秒数万Tokens的高吞吐训练与推理,并确保训推数值误差维持在极低水准。
第三,全链路硬件协同加速。通过跨卡超高带宽互联、定制化显存优化与KV Cache加速技术,不仅大幅压缩多轮复杂推演的首Token等待延迟,还能为数万亿参数的大模型提供稳健的基础支撑。
结语:在AI科研新范式中把握未来
从单点大模型能力的“百模大战”,到如今百万智能体组团上岗的“智能组织”协同,人工智能的聚光灯已然从单纯展示智力水平,转向了实打实的产业与科研生产力重塑。以数以万计的自主智能体为核心,深度整合计算基础设施与物理实验设备,科学研究正在迎来史上最具颠覆性的效率跃迁。
对于关注AI新闻、追踪全球科技风向的开发者与研究者而言,理解智能体与底层架构的深度协同,是读懂未来技术演变的关键钥匙。欢迎持续关注致力于提供全方位AI日报与深度科技解析的权威 AI门户,第一时间掌握全球LLM、智能体及科研自动化的最新突破。
Loading...